파인튜닝이란? 뜻부터 RAG와의 차이, 기업 활용까지
- 등록일 2026년10월23일
본문
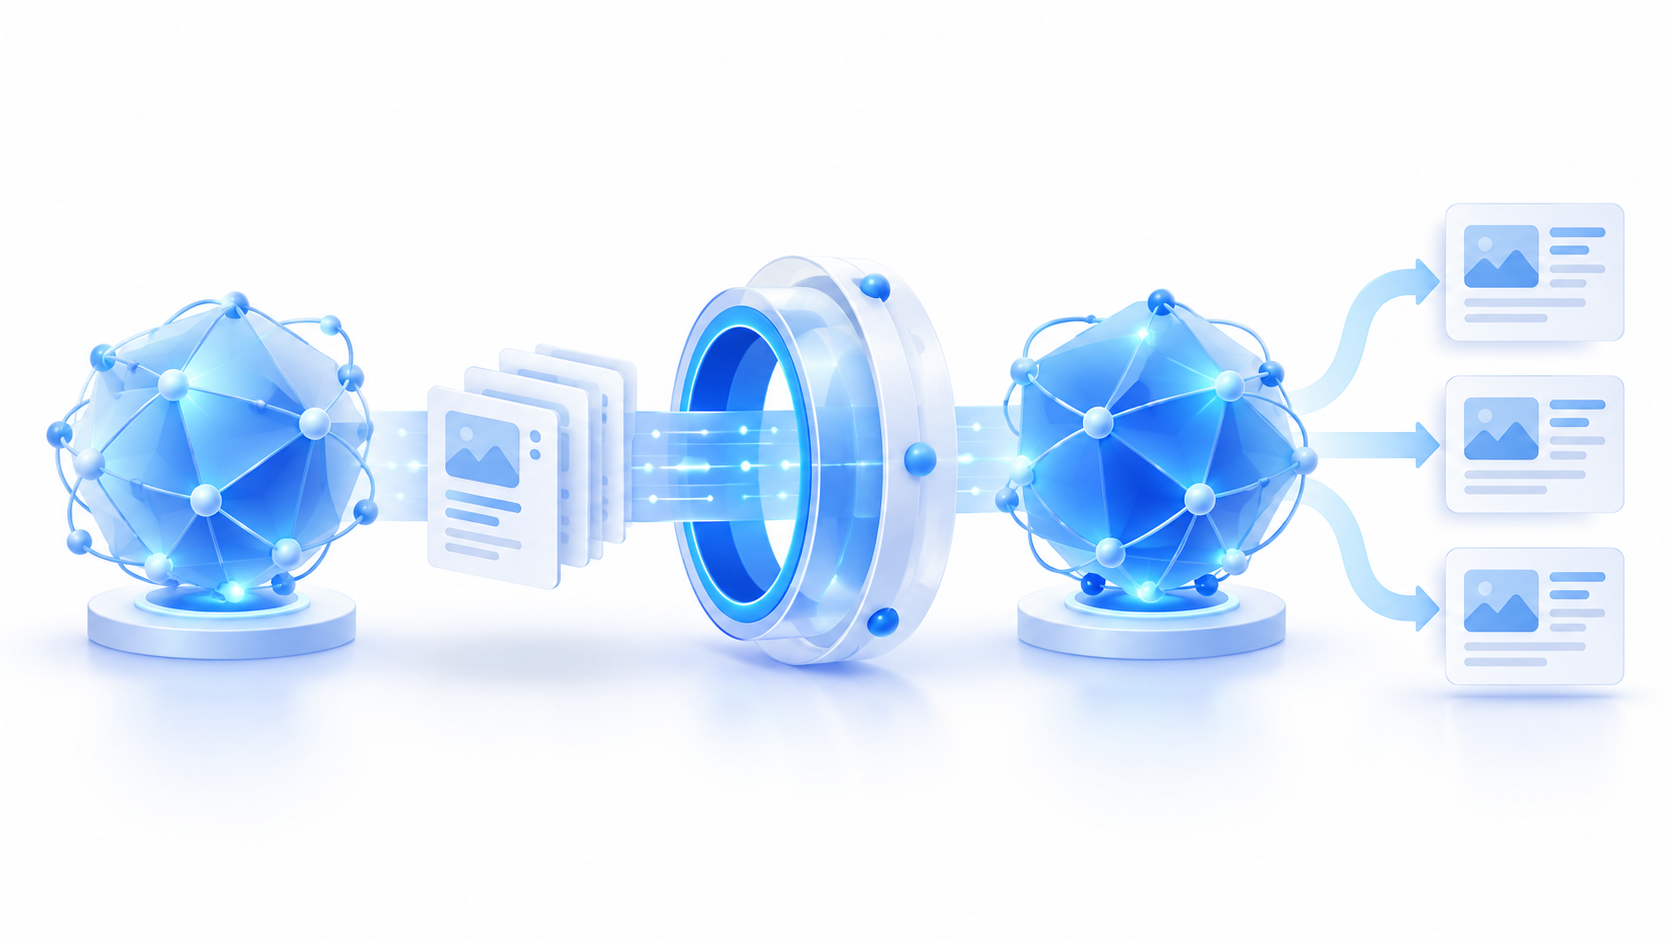
기업이 AI를 도입할 때 중요한 질문은 어떤 모델을 쓸지뿐만이 아닙니다. 반복해서 수정하는 결과가 무엇인지, 그 원인이 정보 부족인지 업무 기준의 불일치인지 구분해야 합니다. 콘텐츠 관리 업무를 기준으로 파인튜닝의 적용 조건을 살펴봅니다.
추가 학습이 필요한 문제와 정보 연결이 필요한 문제
파인튜닝(Fine-tuning)은 이미 학습된 AI 모델을 특정 목적에 맞는 데이터로 추가 학습하는 방법입니다. 대규모 언어 모델(LLM)에서는 모델의 가중치나 추가 학습용 파라미터를 조정해 특정 업무를 더 잘 수행하도록 만듭니다.
콘텐츠 분류 결과가 담당자의 기준과 계속 어긋난다면 검수된 분류 사례를 학습시키는 방법을 검토할 수 있습니다. 반면 변경된 제품 정보를 답변하지 못한다면 최신 자료에 접근하는 구조를 먼저 살펴야 합니다. 동일한 오답이라도 개선할 지점은 다를 수 있습니다.
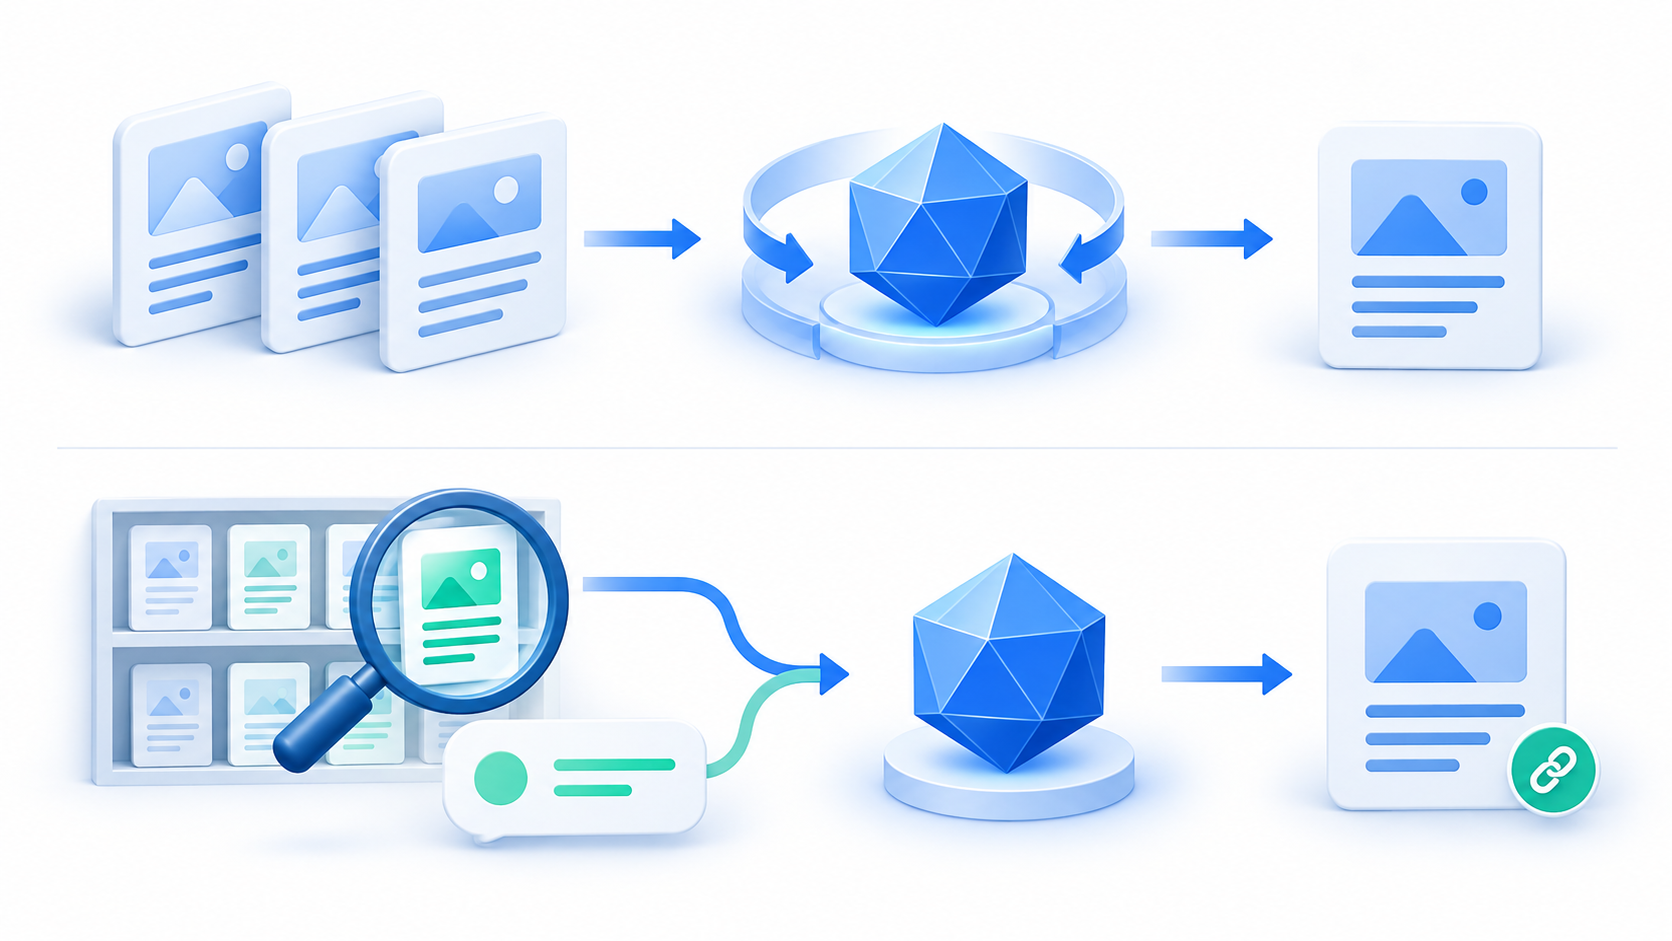
프롬프트는 요청에 지시와 예시를 담고, RAG는 관련 자료를 검색해 답변의 참고 정보로 제공합니다. 파인튜닝은 데이터로 추가 학습해 모델을 조정합니다. 세 방법은 함께 사용할 수도 있습니다.[1]
기업 콘텐츠 업무에 적용하는 판단 기준
| 업무에서 관찰한 문제 | 우선 검토할 접근 | 검증할 항목 |
|---|---|---|
| 원하는 요약 길이와 구성이 불명확함 | 프롬프트에 기준과 예시 명시 | 정보 누락·출력 형식 준수 |
| 최신 운영 정책을 답변에 반영하지 못함 | RAG 또는 시스템 조회 연결 | 자료 최신성·검색 적합성·근거 일치 |
| 일정한 문서 분류 기준을 반복해서 놓침 | 프롬프트 기준선과 파인튜닝 비교 | 학습 외 문서의 분류 정확도 |
위 표는 도입을 검토하기 위한 제안이며 실제 고객의 도입 결과가 아닙니다. 업무 성격과 모델에 따라 평가 결과는 달라질 수 있습니다.
CMS에 쌓인 콘텐츠를 학습 사례로 만들려면
가령 원고를 ‘제품 소식·기술 인사이트·고객 사례’로 분류하는 업무라면, 원문과 담당자가 확정한 분류값을 짝지어 학습 사례로 구성할 수 있습니다. 원고를 일정한 구조로 요약하려는 경우에는 원문과 검수된 요약문이 필요합니다. 모두 가상의 활용 예시입니다.
자료를 많이 모으는 것만으로 충분하지는 않습니다. 중복·오류를 정리하고 분류 기준을 통일해야 합니다. 개인정보와 사용 권한을 점검하고, 평가용 자료가 학습 데이터에 섞이지 않도록 구분하는 작업도 필요합니다.
도입 성과는 기존 방식과 비교해 판단합니다
- 개선할 업무와 현재 실패 유형을 정리합니다.
- 현재 모델과 프롬프트의 결과를 기준선으로 남깁니다.
- 검수된 학습 데이터와 별도 평가 데이터를 준비합니다.
- 분류 정확도, 요약의 정보 누락, 검수 시간 등 업무에 맞는 항목으로 비교합니다.
- 품질 개선과 학습·운영·유지보수 부담을 함께 판단합니다.
파인튜닝 자체가 답변의 정확성이나 보안을 보장하지는 않습니다. 최신 자료를 확인할 경로, 접근 통제, 사람의 결과 검수는 서비스 운영 관점에서 함께 설계해야 합니다. 콘텐츠 관리에서는 자료를 모으는 단계부터 검수 결과를 남기는 단계까지 일관된 데이터 관리가 출발점입니다.
참고자료
[1] IBM: RAG·파인튜닝·프롬프트 비교
[2] Red Hat: RAG vs. fine-tuning (2026.05.12)
[3] AWS: RAG와 파인튜닝 비교